مفهوم اصلی: Vector Database چه مسئلهای را حل میکند؟
در یک سیستم RAG در محیط Production باید تعداد زیادی Vector را ذخیره و با سرعت زیاد جستوجو کنیم. پایگاهدادهای که از ابتدا برای دادههای برداری با ابعاد بالا و الگوریتمهایی مانند ANN طراحی شده، Vector Database نام دارد.
Vector Database فقط «جدولی از عددها» نیست؛ علاوه بر Vector، متن اصلی، شناسه و Metadata را نگه میدارد، برای جستوجوی سریع Index میسازد و نتیجهها را همراه با Distance یا Score برمیگرداند.
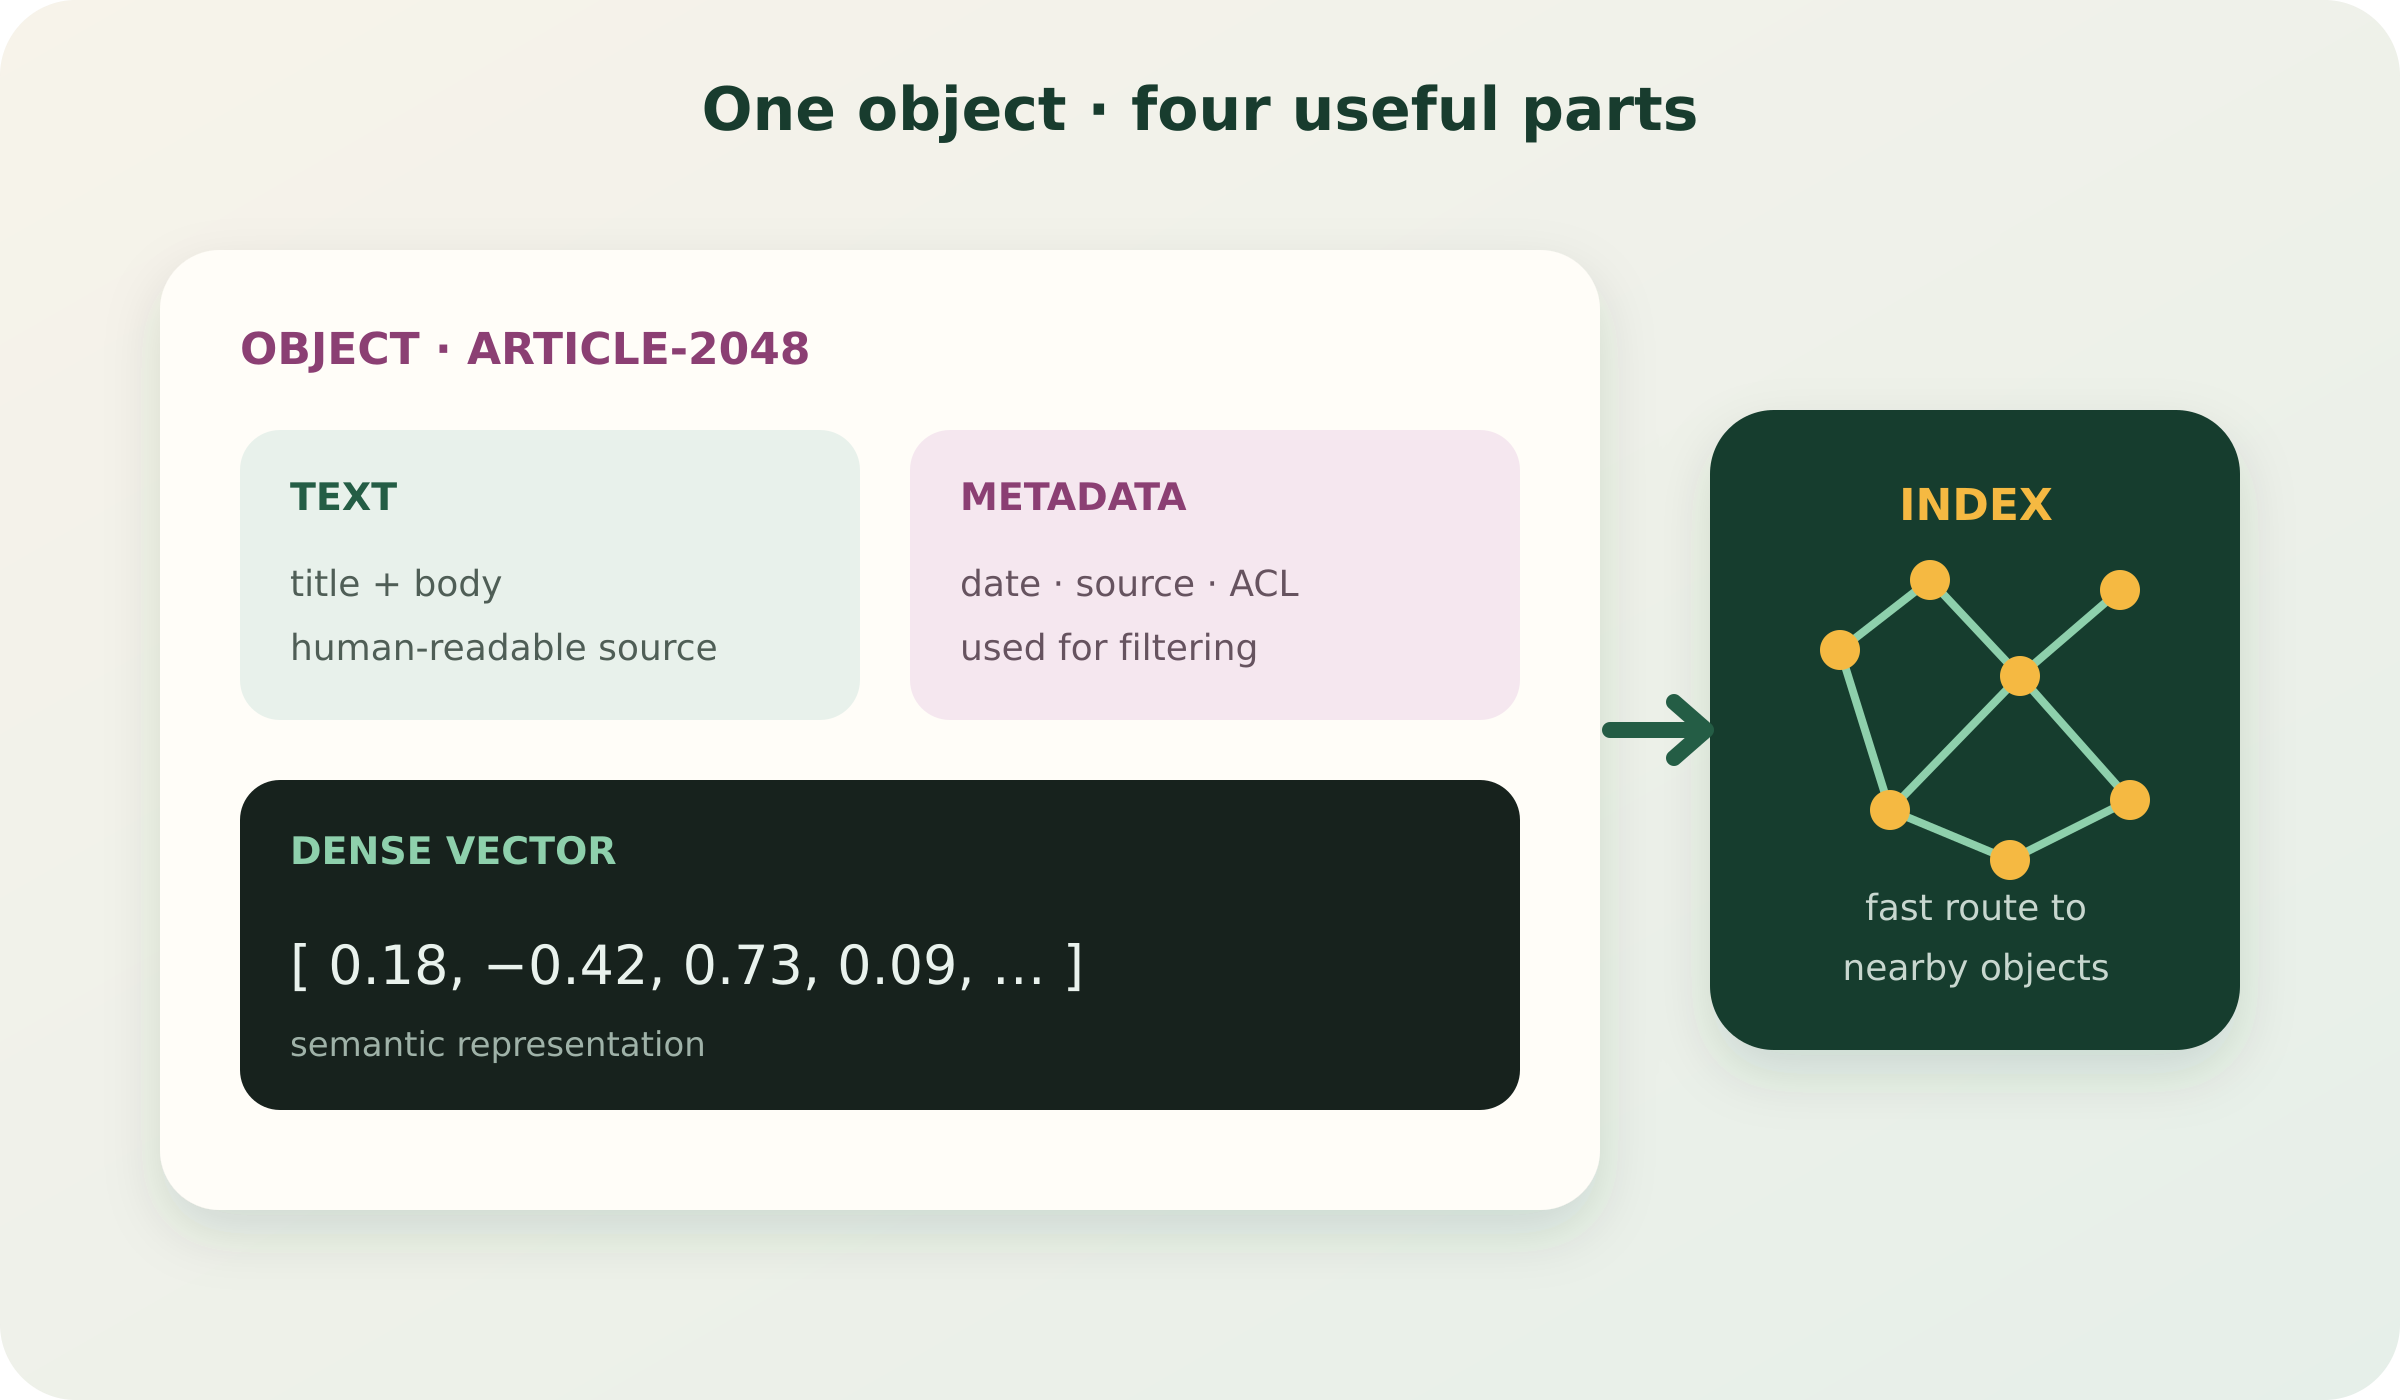
چرا Vector Databaseها به وجود آمدند؟
با گسترش Large Language Modelها، Embedding Modelها و Semantic Search در اوایل دههٔ ۲۰۲۰، نیاز به ذخیره و جستوجوی سریع Vectorها رشد کرد. Relational Database معمولی، بدون افزونه و Index تخصصی، بیشتر شبیه KNN عمل میکند و در مقیاس بزرگ مجبور است فاصلهٔ Query را با تعداد زیادی رکورد حساب کند.
Vector Databaseها این مسیر را برای عملیات برداری بهینه میکنند:
- ساخت Proximity Graph برای الگوریتمهایی مانند HNSW؛
- محاسبهٔ معیارهایی مانند Cosine Similarity و Distance؛
- بازیابی سریع Top-K در مجموعههای بزرگ؛
- ترکیب Semantic Search با Keyword Search و Metadata Filtering.
در نتیجه، مقیاسپذیری و سرعت بیشتری برای سیستمهای RAG به دست میآید.
Vector Database این دوره: Weaviate
در این دوره از Weaviate استفاده میشود؛ یک Vector Database متنباز که هم بهصورت Local و هم در Cloud قابل اجراست. محصولهای مختلف جزئیات API متفاوتی دارند، اما Workflow عمومی آنها شبیه است. هدف اصلی، فهمیدن الگوی کار است: تعریف ساختار داده، ورود Document، ساخت Vector و Index، Query و Filtering.
آمادهسازی Vector Database برای Retrieval
پیش از اولین Search، داده باید یک مسیر مشخص را طی کند. خروجی این مسیر، Databaseای است که هم جستوجوی Keyword و هم جستوجوی Semantic را پشتیبانی میکند.
- راهاندازی Database: یک Instance جدید میسازیم یا به Instance موجود متصل میشویم.
- بارگذاری Documentها: سندهای Knowledge Base را همراه با شناسه و Metadata وارد میکنیم.
- ساخت Sparse Vector: برای Keyword Search، اطلاعاتی بر اساس حضور و فراوانی واژهها ساخته میشود.
- ساخت Dense Embedding: برای Semantic Search، هر Document با Embedding Model به Dense Vector تبدیل میشود.
- ساخت ANN Index: برای جستوجوی سریع برداری، Indexای مانند HNSW ساخته میشود.
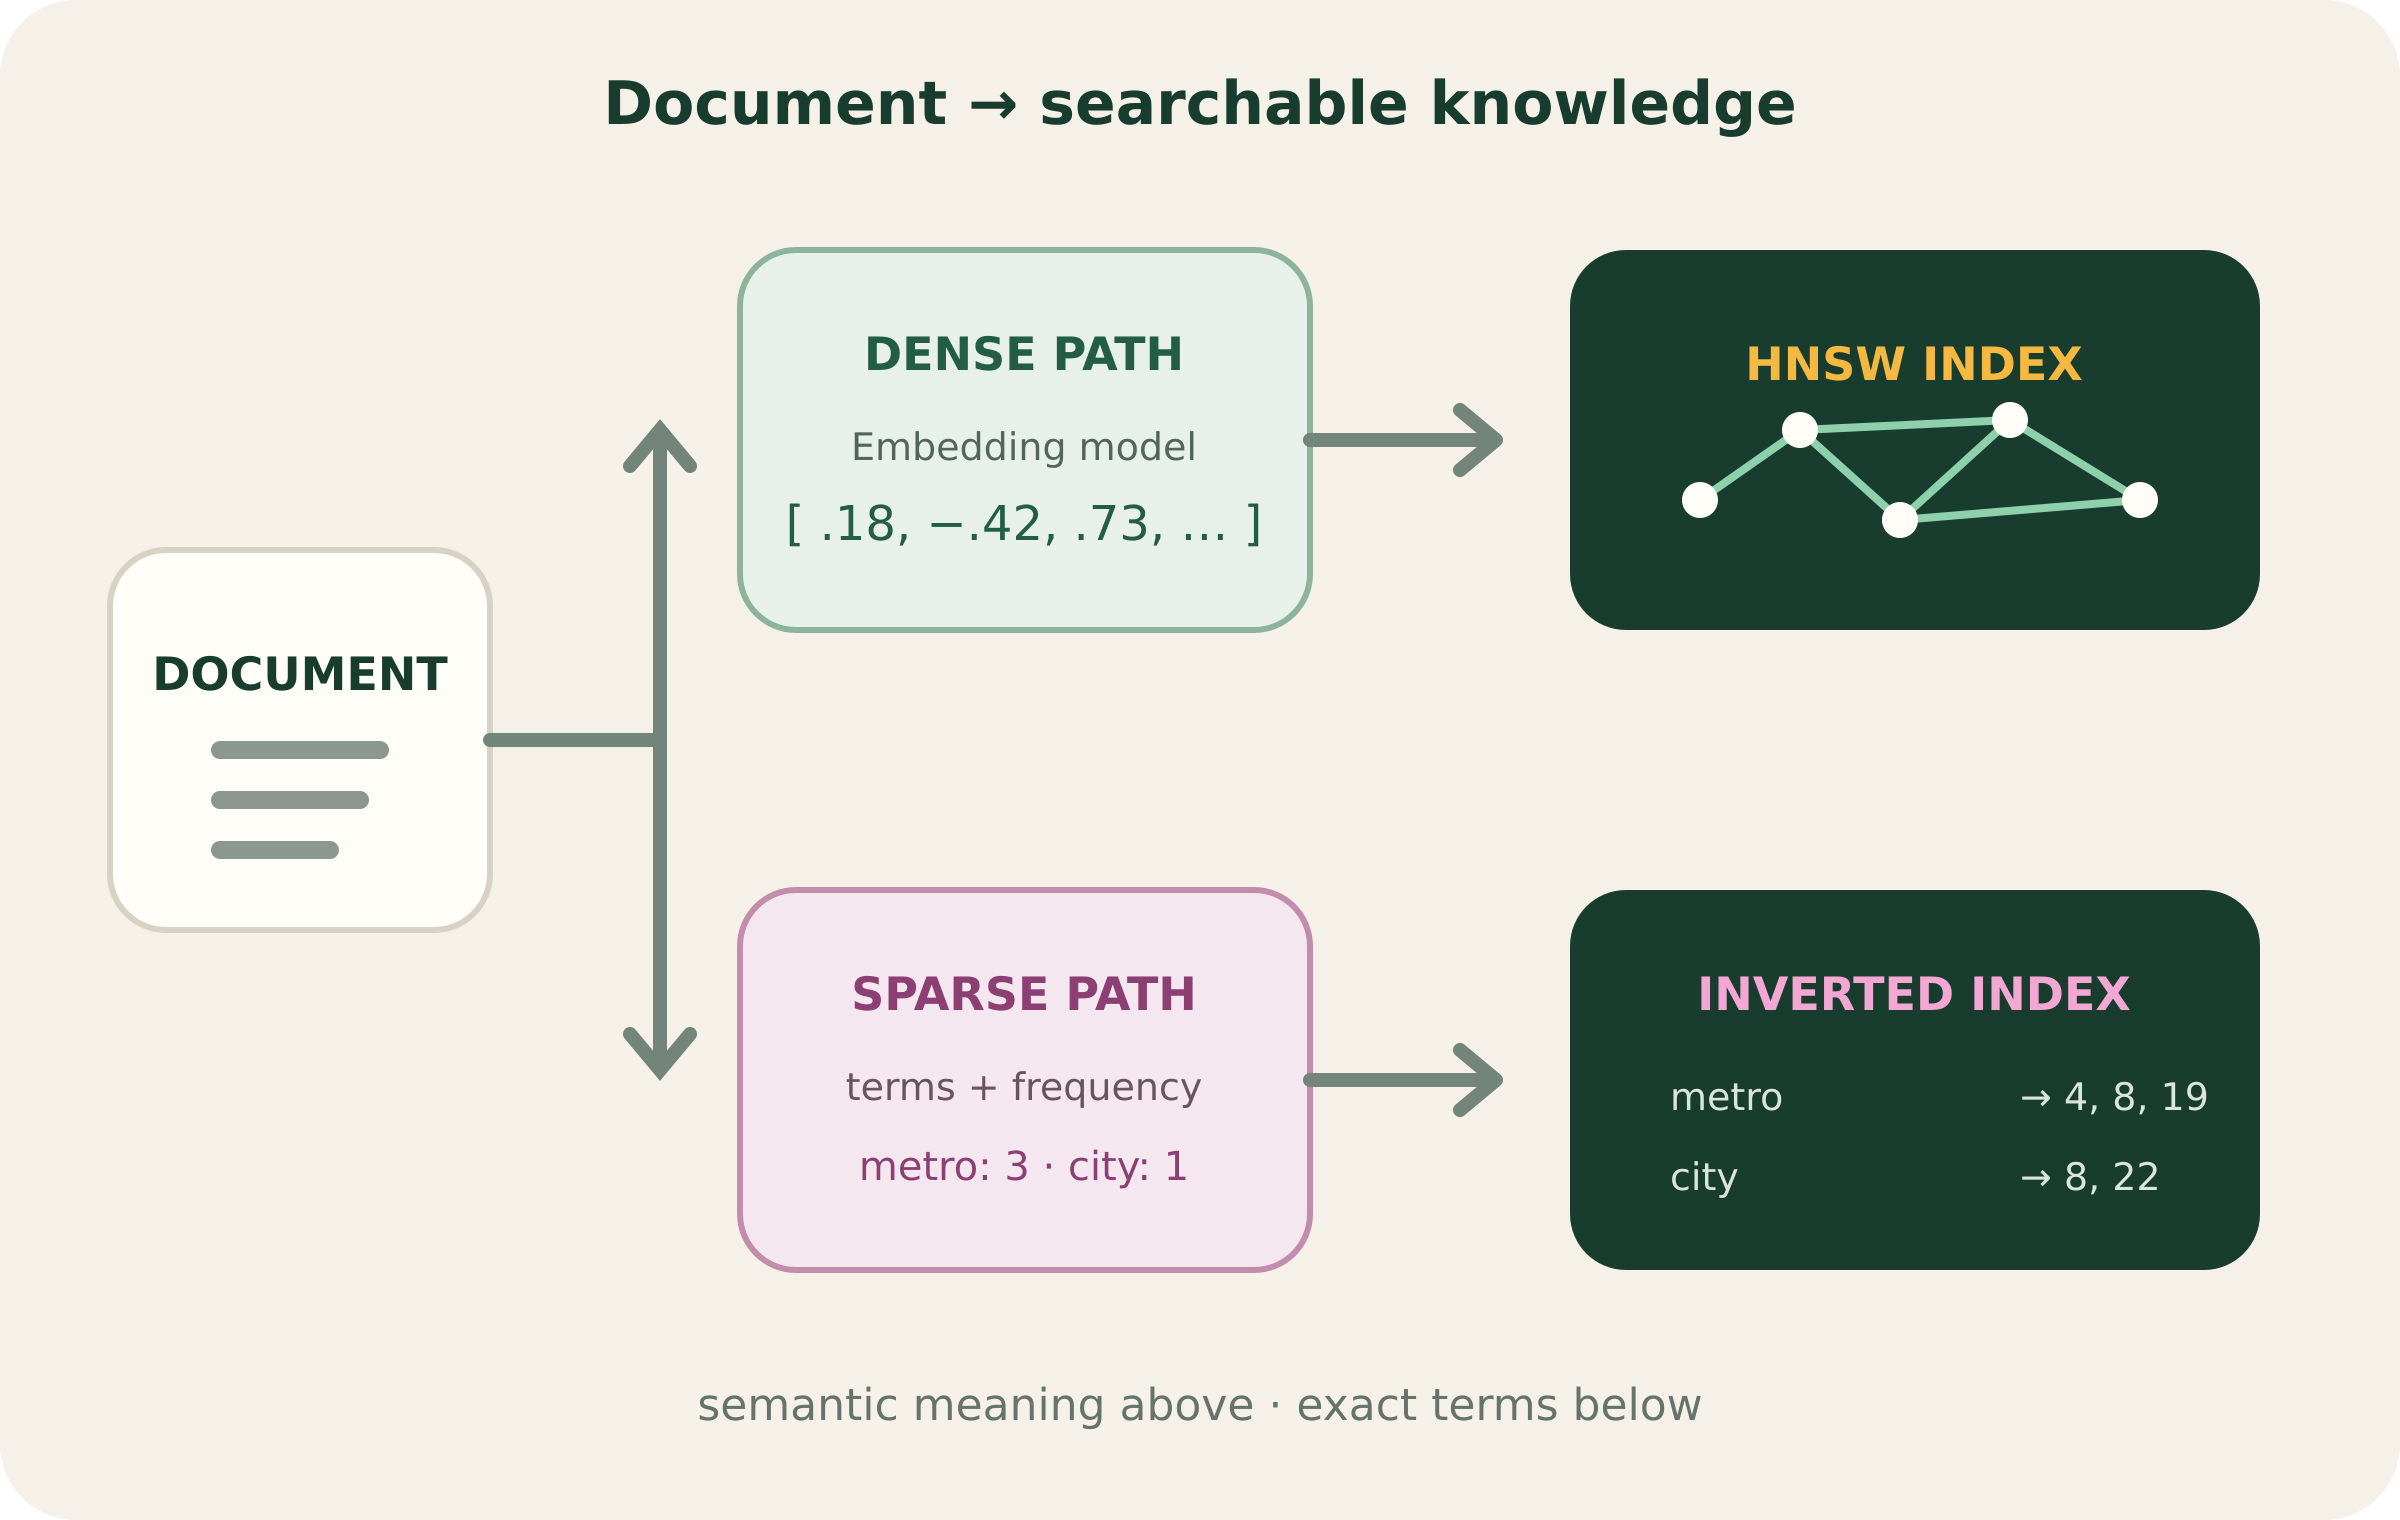
مثال: از یک خبر تا Object قابل جستوجو
{
"title": "افتتاح خط جدید مترو",
"body": "خط جدید مترو امروز به بهرهبرداری رسید.",
"category": "شهر",
"published_at": "2026-09-08"
}کلمههایی مانند «مترو» در Inverted Index ثبت میشوند؛ همزمان متن با Embedding Model به یک Dense Vector تبدیل میشود. اکنون Query «خبرهای جدید حملونقل شهری» حتی بدون تکرار دقیق واژهٔ «مترو» میتواند این سند را از مسیر معنایی پیدا کند.
Workflow در Weaviate
۱. اتصال و ساخت Collection
ابتدا یک Instance جدید ساخته میشود یا به Instance موجود متصل میشویم. دادهها در Weaviate داخل Collection ذخیره میشوند. برای مثال، Collectionای به نام Article میتواند مقالههای خبری را نگه دارد.
هنگام ساخت Collection، Propertyها و نوع آنها مشخص میشوند:
Collection: Article
title        → text
body         → text
category     → text
published_at → date
همچنین تعیین میکنیم کدام Embedding Model برای ساخت Semantic Vector استفاده شود. پس از آن، هر Article واردشده به Vector تبدیل میشود و در Semantic Search شرکت میکند.
۲. افزودن دادهها با Batch
برای ورود تعداد زیادی Object میتوان از Batch Method استفاده کرد. عملیاتی مانند Batch.addObject Objectها را اضافه میکند و امکان ثبت تعداد خطاها را میدهد.
فرض کنید ۱۰٬۰۰۰ مقاله وارد میکنیم و ۱۲ مورد بهدلیل تاریخ نامعتبر شکست میخورند. با ثبت خطا میتوان همان ۱۲ مورد را اصلاح و دوباره ارسال کرد؛ اگر نسبت خطا غیرعادی باشد، بهتر است فرآیند متوقف شود.
۳. اجرای Vector Search و خواندن Distance
پس از ورود دادهها، Collection و متن Query را مشخص میکنیم. Weaviate برای Query نیز Vector میسازد، نزدیکترین Objectها را پیدا میکند و میتواند Distance هر نتیجه را برگرداند.
Query: "حملونقل عمومی در پایتخت"
Top result: "افتتاح خط جدید مترو"
Distance: 0.12Distance فاصلهٔ Query Vector و Object Vector است. در یک معیار فاصله، مقدار کمتر معمولاً یعنی نزدیکی بیشتر؛ اما تفسیر دقیق Score یا Distance باید با معیار انتخابشده و API همان Database انجام شود.
Keyword Search و Inverted Index
Weaviate برای Keyword Search یک Inverted Index میسازد. این Index مشخص میکند هر کلمه در کدام Documentها آمده و فراوانی آن چقدر است. با این ساختار میتوان BM25 Query اجرا کرد؛ مثلاً سه سند برتر شامل عبارت دقیق «HNSW» را خواست.
Keyword Search برای نام محصول، شمارهٔ خطا، کد قرارداد یا اصطلاحی که باید دقیقاً تطبیق پیدا کند مفید است. Vector Search در مقابل، ارتباط معنایی را بهتر تشخیص میدهد.
Hybrid Search؛ معنا و واژه بهصورت همزمان
در Hybrid Search، Vector Search و Keyword Search بهصورت موازی اجرا میشوند. امتیازهای دو مسیر ترکیب و نتایج دوباره رتبهبندی میشوند؛ بنابراین یک نتیجه میتواند هم بهدلیل معنای نزدیک و هم بهدلیل تطابق واژههای مهم امتیاز بگیرد.
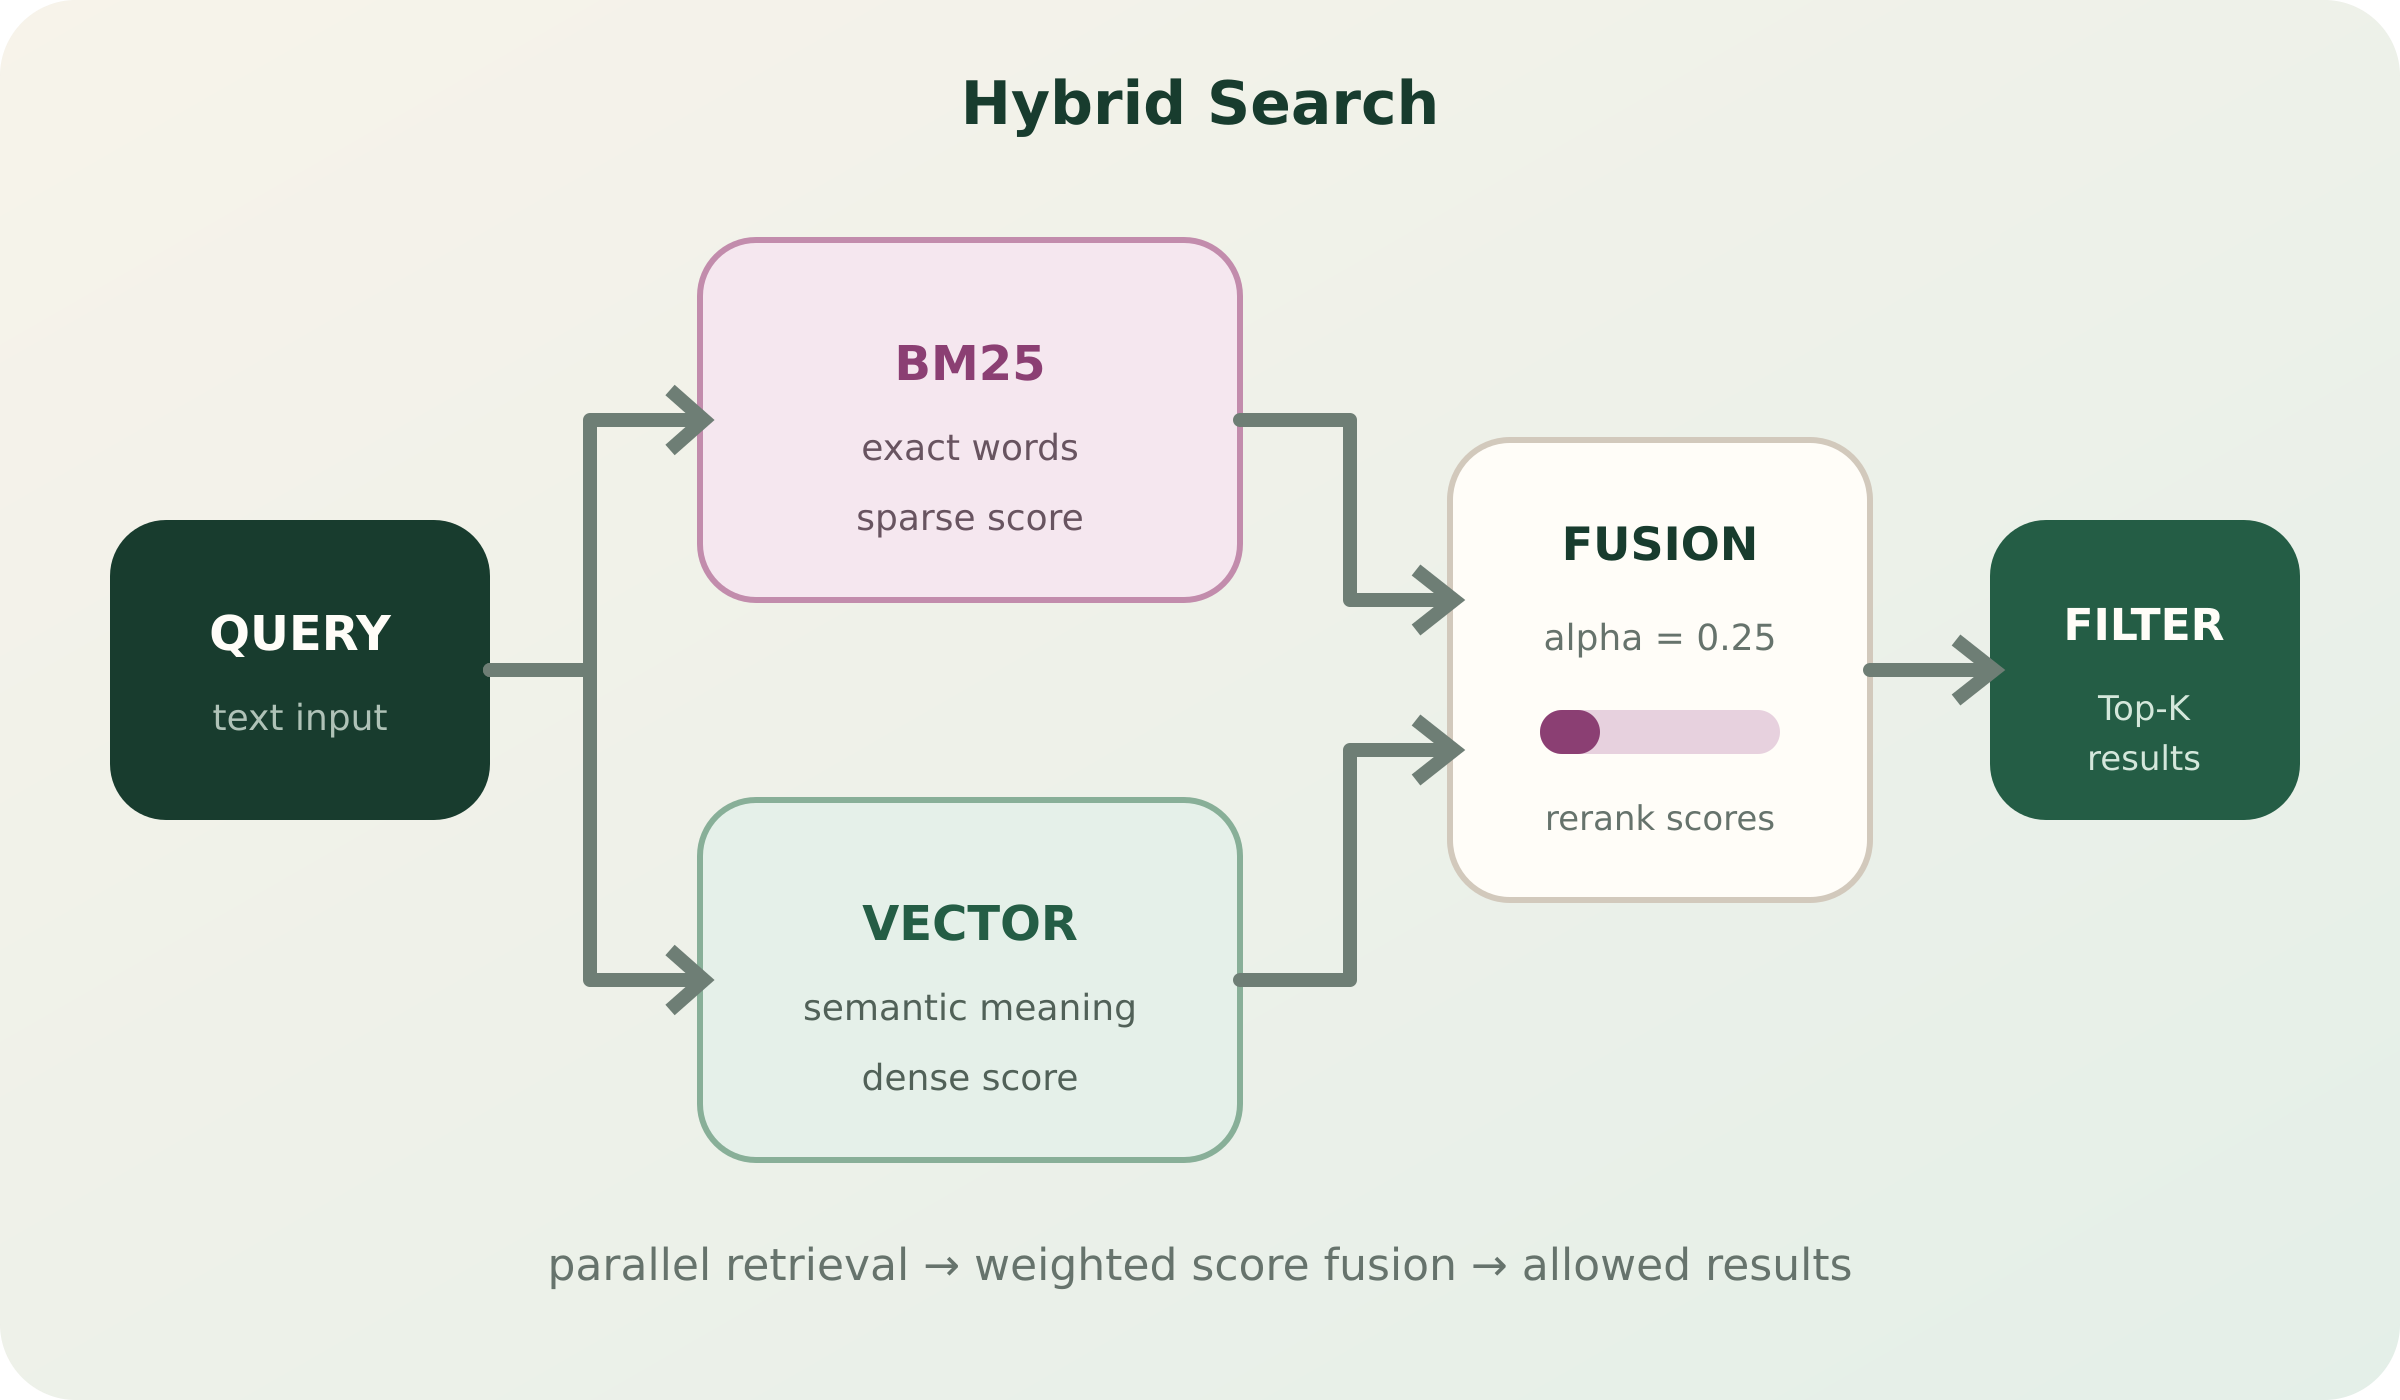
پارامتر Alpha چه میکند؟
Alpha وزن هر روش را تعیین میکند. در قرارداد توضیحدادهشده در این درس:
alpha = 0.25

25%  Vector Search
75%  Keyword Search
برای Query شامل کدی دقیق مانند ERR-429 میتوان وزن Keyword را بیشتر کرد؛ برای پرسشی محاورهای مانند «چرا درخواستها گاهی رد میشوند؟» وزن Vector Search معمولاً مفیدتر است. مقدار مناسب را باید با Queryهای واقعی و Eval پیدا کرد.
چرا Hybrid Search در Production رایج است؟
| روش | نقطهٔ قوت | مثال |
|---|---|---|
| Vector Search | شباهت معنایی | «هزینهٔ ارسال» را نزدیک به «تعرفهٔ پست» میبیند. |
| Keyword Search | تطابق دقیق کلمات | شناسهٔ «INV-2048» را دقیق پیدا میکند. |
| Hybrid Search | تعادل میان هر دو | هم موضوع فاکتور و هم شناسهٔ دقیق آن را لحاظ میکند. |
اعمال Filter روی Search
Metadata Filter مشخص میکند کدام Object اجازهٔ حضور در نتیجه را دارد. اگر شرط برقرار باشد Object عبور میکند؛ در غیر این صورت حذف میشود.
Query: "بهروزرسانی قوانین مرخصی"
Filter:
department = "HR"
valid_from <= today
access_group contains "employees"در این مثال، حتی یک سند بسیار مشابه نیز اگر متعلق به واحد دیگری باشد یا کاربر مجوز دیدنش را نداشته باشد، نباید وارد Context شود. Filter میتواند روی تاریخ، دستهبندی، زبان، tenant یا سطح دسترسی اعمال شود.
Workflow کامل Vector Database
1. Configure Database and Collection
2. Load Documents and Metadata
3. Create Sparse and Dense representations
4. Build ANN / HNSW Index
5. Run Vector, BM25, or Hybrid Query
6. Apply Metadata and access Filters
7. Return Top-K Documents to the RAG pipelineجمعبندی
- Vector Databaseها برای ذخیره و جستوجوی Vectorهای حجیم طراحی شدهاند و برای ANN و HNSW بهینهاند.
- Relational Databaseهای معمولی بدون قابلیت برداری تخصصی، در Semantic Search بزرگ عملکرد ضعیفتری دارند.
- Weaviate یک Vector Database متنباز است که در این دوره برای یادگیری Workflow عمومی استفاده میشود.
- آمادهسازی شامل راهاندازی Database، بارگذاری Document، ساخت Sparse Vector، ساخت Dense Embedding و ایجاد ANN Index است.
- Weaviate از Vector Search، Keyword Search مبتنی بر BM25، Hybrid Search و Filtering پشتیبانی میکند.
- Hybrid Search رایج است، چون شباهت معنایی و تطابق دقیق کلمات را در یک رتبهبندی ترکیب میکند.