ایدهٔ اصلی: چرا به ANN نیاز داریم؟
یک Retriever در مقیاس Production معمولاً از دو پایه استفاده میکند: Keyword Search برای تطابق دقیق واژهها و Semantic Search برای پیدا کردن متنهایی که از نظر معنا به پرسش نزدیکاند. در Semantic Search، سند و پرسش به Vector تبدیل میشوند؛ اما هرچه تعداد Vectorها بیشتر شود، جستوجوی ساده پرهزینهتر خواهد شد.
اگر برای هر پرسش، فاصلهٔ بردار پرسش را با تکتک بردارهای Knowledge Base حساب کنیم، مصرف منابع بالا میرود، Latency افزایش پیدا میکند و مقیاسپذیری کم میشود. خانوادهٔ الگوریتمهای Approximate Nearest Neighbors یا ANN برای حل همین مسئله ساخته شدهاند.
KNN؛ پاسخ دقیق با جستوجوی کامل
سادهترین روش Vector Retrieval، جستوجوی k-Nearest Neighbors یا KNN است. حرف k میگوید چند همسایهٔ نزدیک باید برگردانده شود؛ مثلاً اگر k = 3 باشد، سه سندی را میخواهیم که بردارشان به بردار پرسش نزدیکتر است.
- برای هر Document در Knowledge Base یک Embedding Vector ساخته میشود.
- Prompt کاربر نیز با همان Embedding Model به Query Vector تبدیل میشود.
- فاصلهٔ Query Vector با تمام Document Vectorها محاسبه میشود.
- Documentها بر اساس فاصله مرتب و نزدیکترین
kمورد انتخاب میشوند.
مثال عددی: هزینهای که خطی رشد میکند
اگر مخزن دانش ۱٬۰۰۰ سند داشته باشد، هر Query به ۱٬۰۰۰ محاسبهٔ فاصله نیاز دارد. با یک میلیارد سند، همان روش باید یک میلیارد فاصله را حساب کند:
1,000 documents       → 1,000 distance calculations
1,000,000,000 docs    → 1,000,000,000 distance calculations
پس هزینهٔ KNN با تعداد اسناد بهصورت خطی افزایش پیدا میکند. این روش برای مجموعههای کوچک یا زمانی که دقت مطلق مهمتر از سرعت است مناسب است، اما در مقیاس بزرگ پاسخگویی سریع را دشوار میکند.
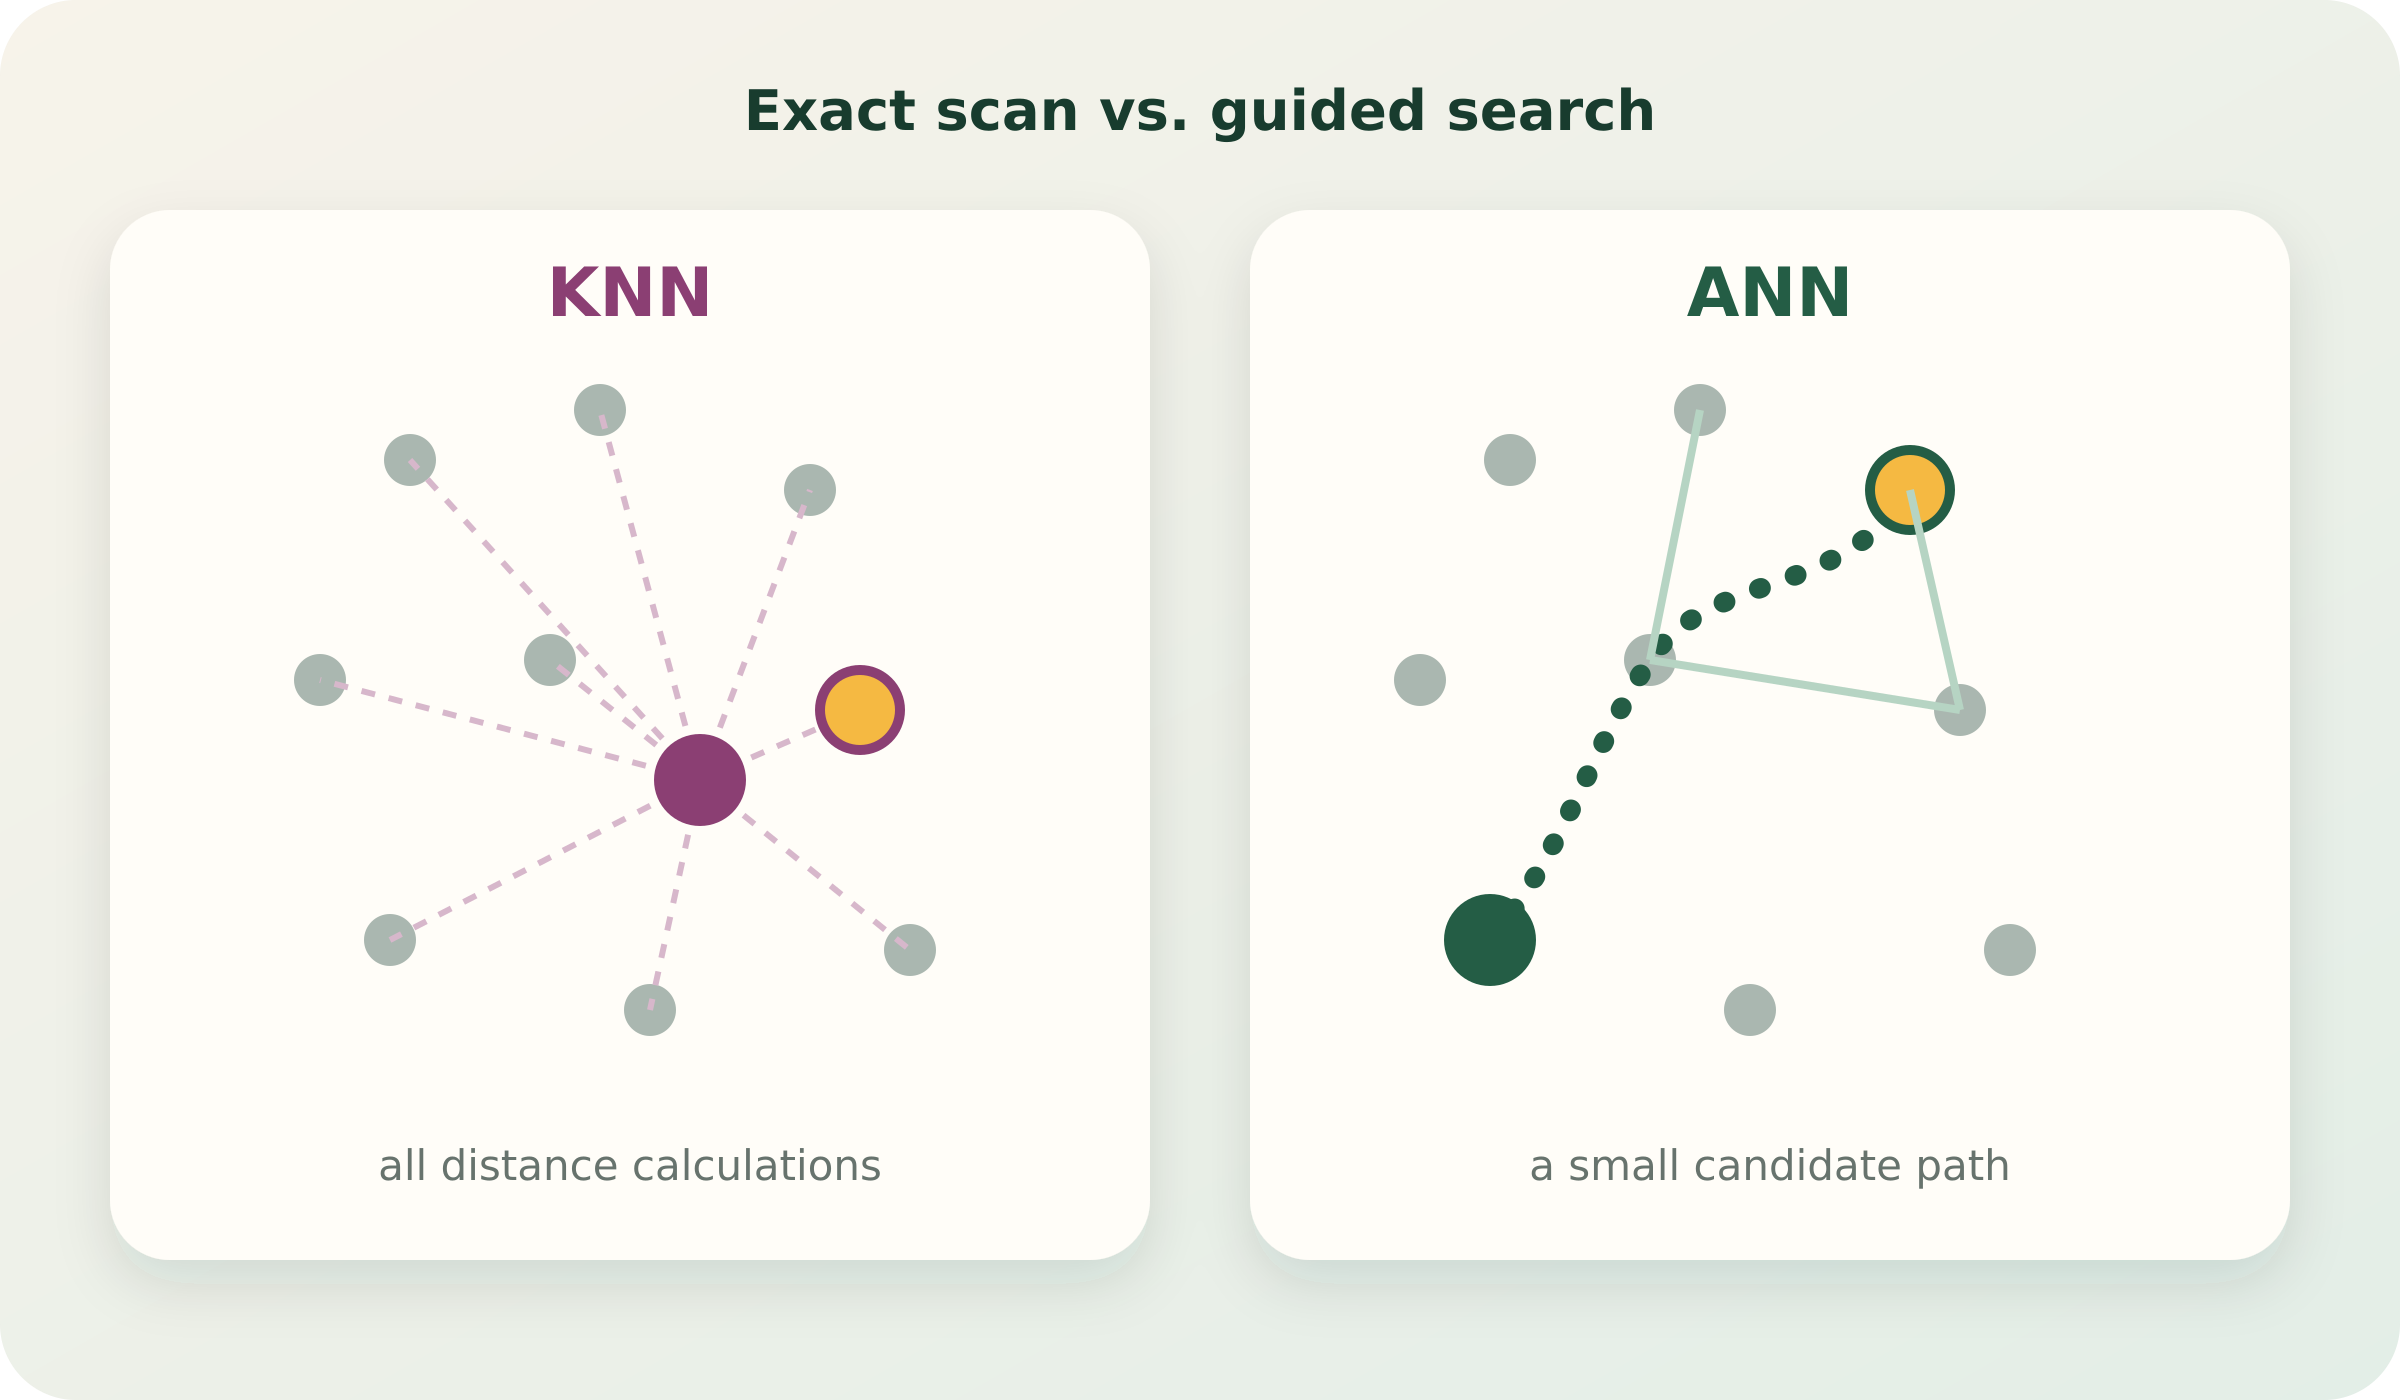
ANN؛ مصالحهٔ آگاهانه میان سرعت و دقت
ANN بهجای مقایسه با همهٔ بردارها، یک ساختار دادهٔ هوشمند یا Index میسازد تا جستوجو را به همسایگیهای محتمل محدود کند. نتیجه این است که جستوجو روی میلیونها یا میلیاردها Vector بسیار سریعتر میشود.
ANN تضمین نمیکند همیشه نزدیکترین Vector مطلق را پیدا کند؛ اما معمولاً بردارهایی بسیار نزدیک را با هزینهای بسیار کمتر برمیگرداند.
این همان مصالحهٔ اصلی است: احتمال کوچکی از خطا را میپذیریم تا Latency بهشدت کاهش یابد. در RAG، اگر سند رتبهٔ اول و دوم تقریباً هممعنا باشند، این مصالحه اغلب پذیرفتنی است؛ مخصوصاً وقتی چند نتیجهٔ برتر را برای Reranking میفرستیم.
NSW؛ حرکت روی گراف همسایگی
یکی از الگوریتمهای رایج ANN، Navigable Small World یا NSW است. NSW از یک Proximity Graph استفاده میکند: هر Document یک Node است و هر Node با Edge به چند بردار نزدیک خود وصل میشود.
ساخت Proximity Graph
- محاسبهٔ فاصله: فاصلهٔ Vectorهای مختلف اندازهگیری میشود.
- ساخت Node: هر Document به یک گره در گراف تبدیل میشود.
- ایجاد Edge: هر Node به چند همسایهٔ نزدیک خود متصل میشود.
این مرحله معمولاً پیش از رسیدن Prompt انجام میشود؛ یعنی سامانه یکبار برای ساخت Graph هزینه میدهد و سپس Queryهای فراوان را سریعتر پاسخ میدهد.
جستوجو در Graph قدمبهقدم
- Prompt به Query Vector تبدیل میشود.
- الگوریتم از یک Entry Point شروع میکند؛ این Node، Candidate فعلی است و لزوماً نزدیک Query نیست.
- همسایههای Candidate بررسی میشوند و نزدیکترین همسایه جای آن را میگیرد.
- حرکت تا جایی ادامه پیدا میکند که در همسایگی فعلی گزینهٔ بهتری وجود نداشته باشد.
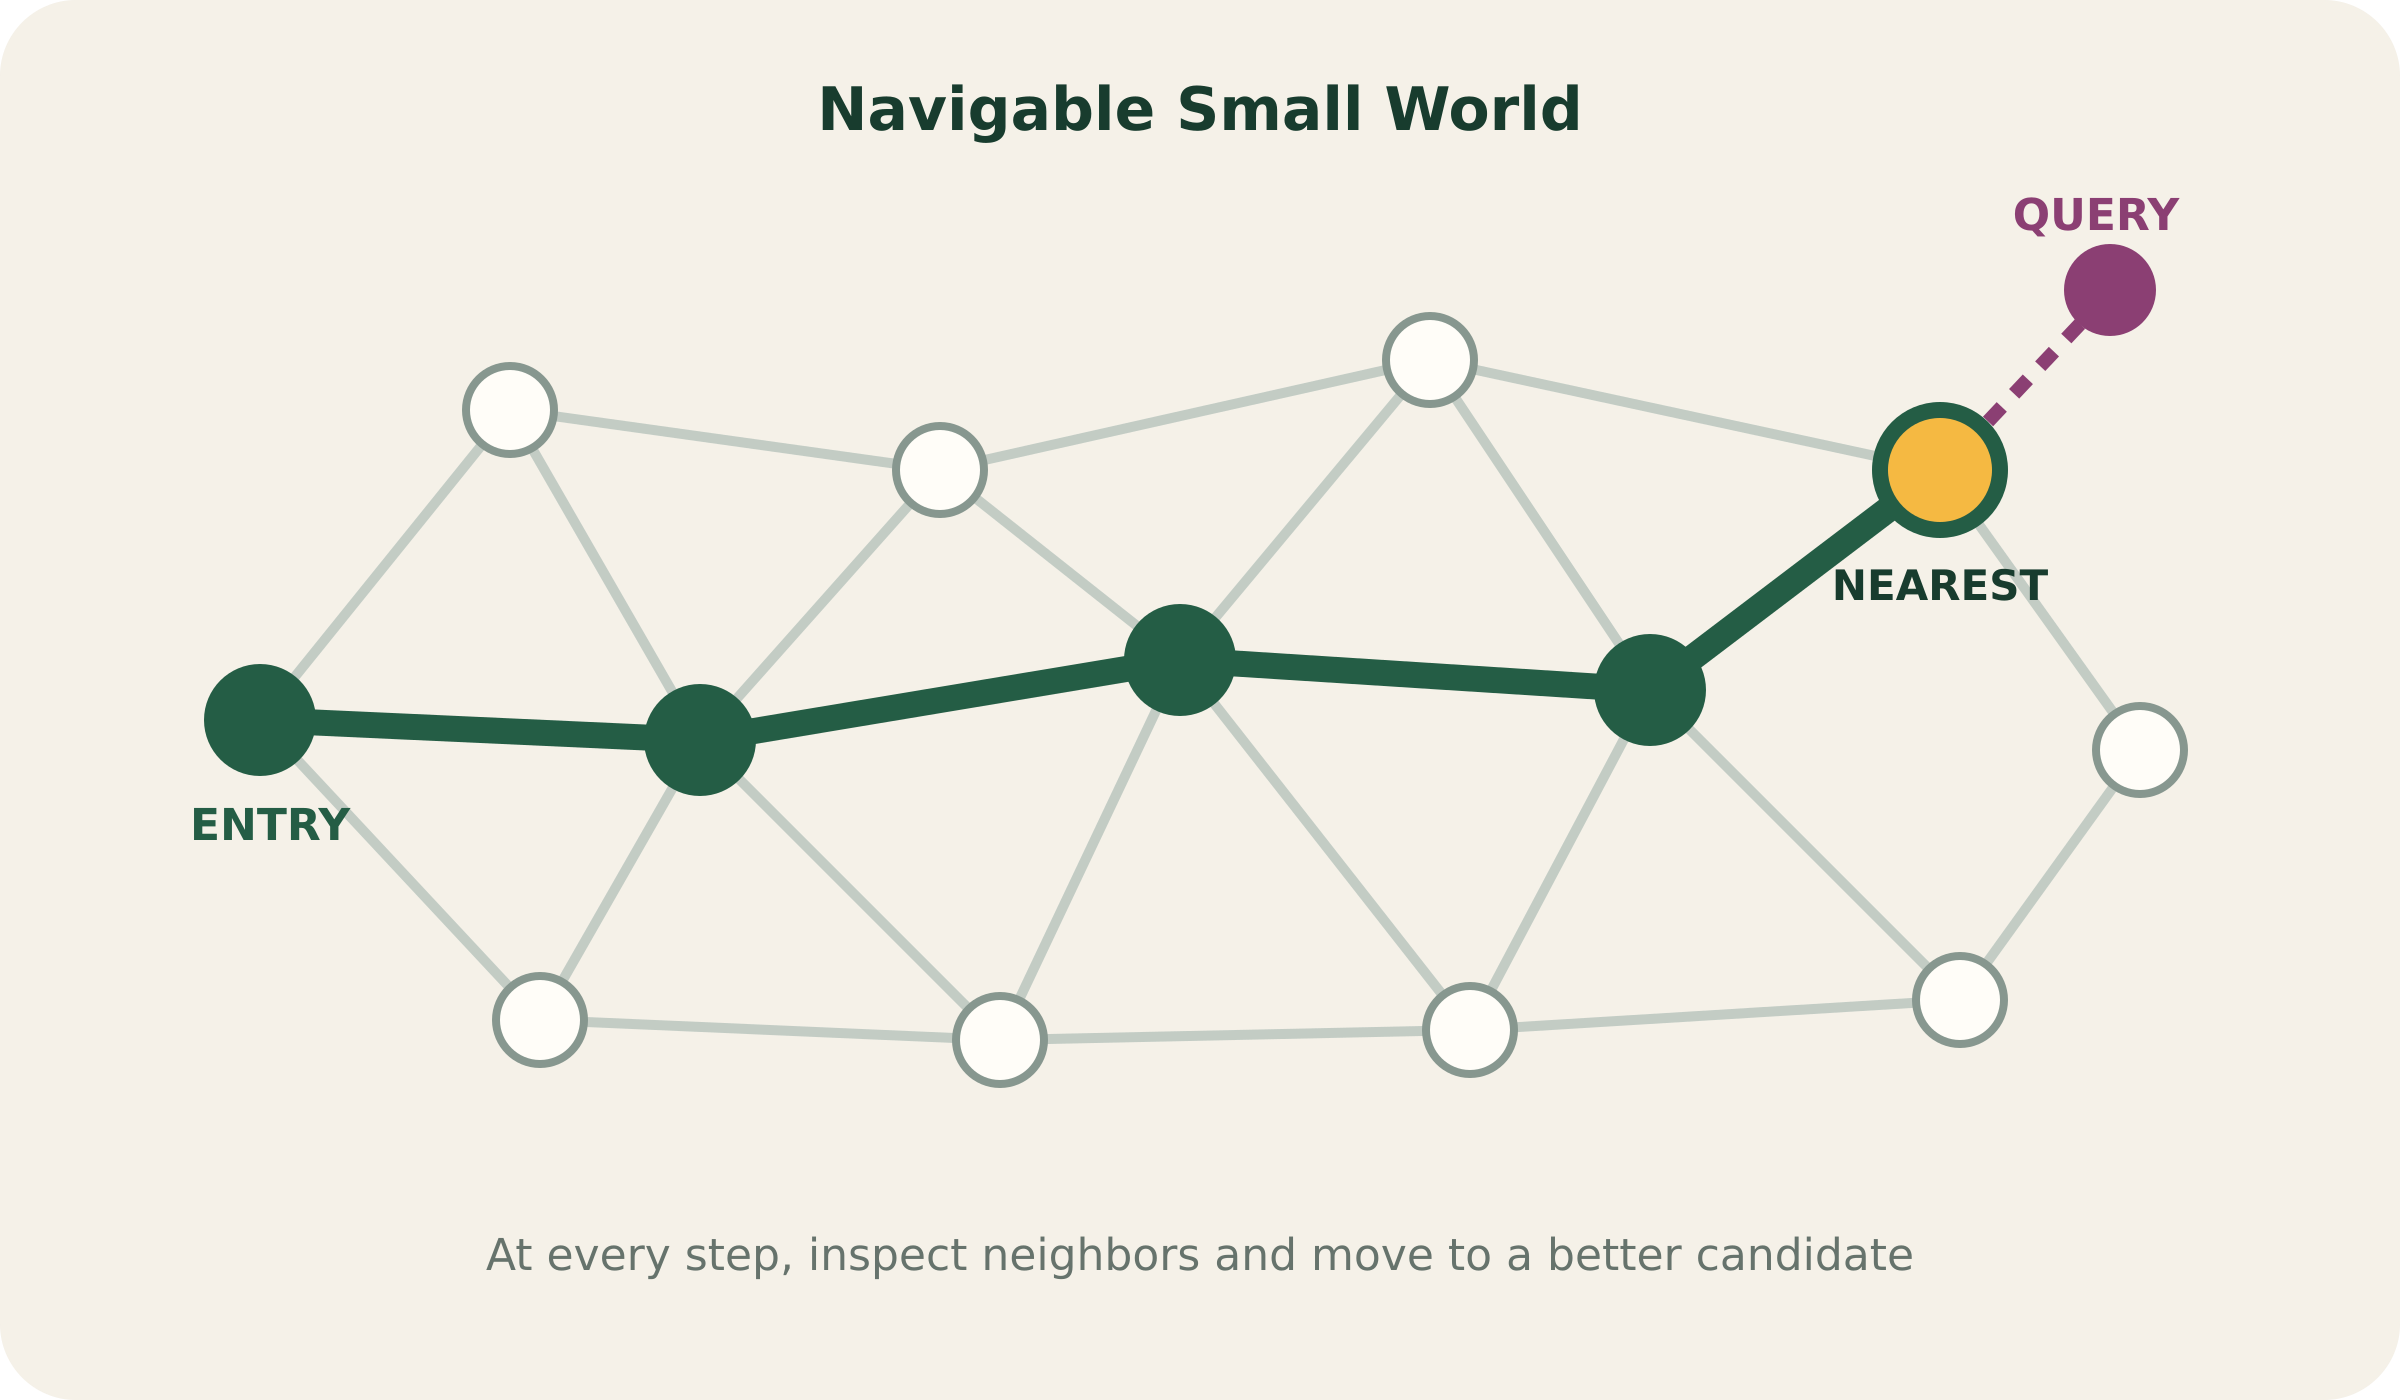
محدودیت NSW: بهترین گزینهٔ محلی
NSW در هر مرحله بهترین انتخاب همان لحظه را انجام میدهد؛ بنابراین ممکن است در ناحیهای خوب متوقف شود، در حالی که ناحیهای بهتر در بخش دیگری از Graph وجود دارد. مثل گیر افتادن روی یک قلهٔ محلی: از جای فعلی هر مسیر کوتاه رو به پایین است، اما پشت یک دره قلهای بلندتر وجود دارد.
با وجود این محدودیت، NSW در عمل Vectorهای بسیار نزدیک را بسیار سریعتر از KNN پیدا میکند. کیفیت اتصالهای Graph و نقطهٔ شروع، روی کیفیت نتیجه اثر مستقیم دارند.
HNSW؛ از نقشهٔ کلی تا جستوجوی محلی
Hierarchical Navigable Small World یا HNSW نسخهٔ بهبودیافتهٔ NSW است. ایدهٔ اصلی آن ساخت چند لایه از Proximity Graph است. لایههای بالا Nodeهای کمتر و پرشهای بلندتر دارند؛ لایهٔ پایین همهٔ Vectorها را نگه میدارد و برای اصلاح دقیق نتیجه استفاده میشود.
ساختار لایهای با یک مثال ساده
اگر Knowledge Base شامل ۱٬۰۰۰ Document باشد، میتوان ساختار را اینطور تصور کرد:
- Layer 3: حدود ۱۰ Vector؛ نقشهای خلاصه برای پرشهای بزرگ.
- Layer 2: حدود ۱۰۰ Vector؛ محدودهٔ جستوجو را دقیقتر میکند.
- Layer 1: هر ۱٬۰۰۰ Vector؛ نزدیکترین همسایه در این لایه نهایی میشود.
این تعدادها فقط برای ساختن تصویر ذهنیاند؛ نکتهٔ اصلی، افزایش تدریجی تراکم از بالا به پایین است.
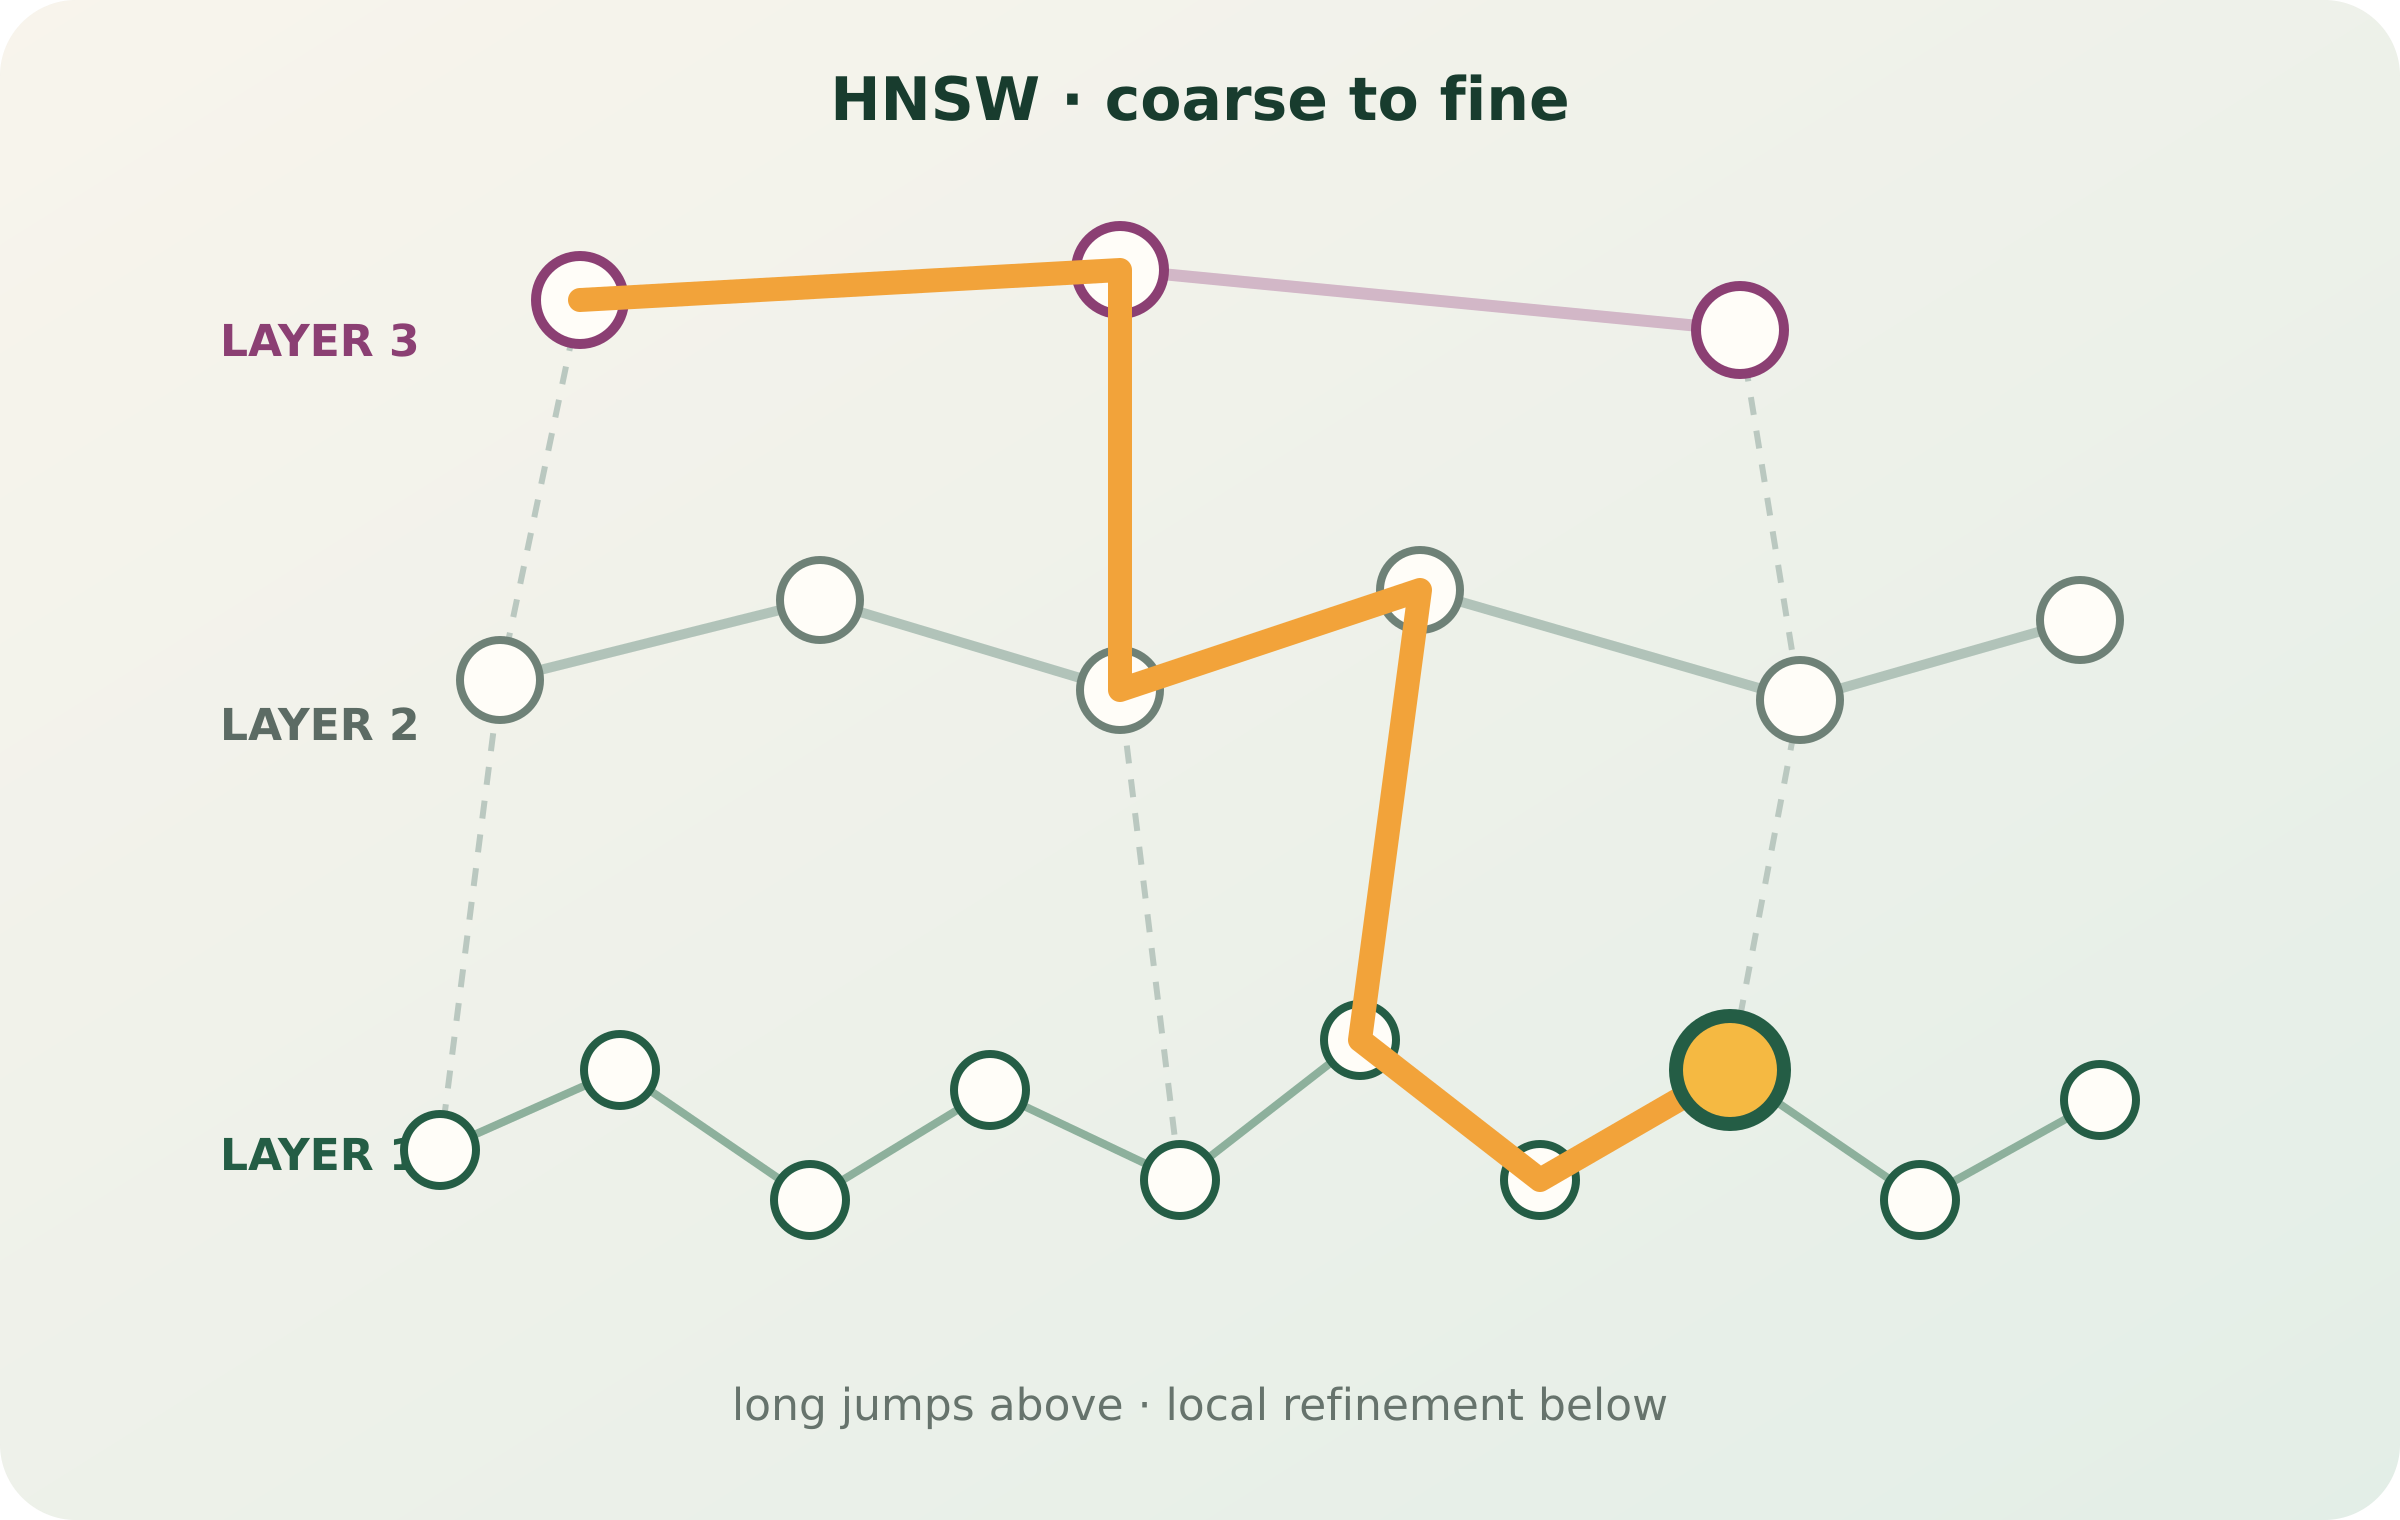
جستوجوی HNSW قدمبهقدم
- جستوجو از Entry Point در بالاترین و خلوتترین Layer شروع میشود.
- الگوریتم روی همان Layer حرکت میکند تا Candidate بهتری پیدا نشود.
- Candidate فعلی بهعنوان Entry Point لایهٔ پایینتر استفاده میشود.
- در هر Layer، با وجود Vectorهای بیشتر، نتیجه دقیقتر میشود.
- در پایینترین Layer بهترین Candidate نهایی برگردانده میشود.
دلیل سرعت HNSW همین جستوجوی درشتبهریز است: در لایههای بالا جهشهای بزرگ انجام میشود و در لایهٔ پایین فقط محدودهٔ کوچکی بررسی میشود. به این ترتیب، جستوجوی میلیونها یا میلیاردها Vector با Latency پایین عملی میشود.
مقایسهٔ HNSW و KNN
| ویژگی | KNN | HNSW |
|---|---|---|
| روش جستوجو | بررسی همهٔ Vectorها | حرکت هدایتشده در Graph |
| سرعت در مقیاس بزرگ | کند | بسیار سریعتر |
| پیچیدگی زمانی | خطی | در عمل نزدیک به لگاریتمی |
| دقت | نتیجهٔ دقیق | نتیجهٔ تقریبی |
| هزینهٔ آمادهسازی | Index پیچیده نمیخواهد | ساخت و نگهداری Graph لازم است |
| مقیاس مناسب | دادهٔ کم یا معیار مرجع | میلیونها و میلیاردها Vector |
نکات مهم ANN
- سرعت: ANN جستوجو را بسیار سریعتر از KNN میکند.
- تقریبی بودن: نزدیکترین Vector مطلق تضمین نمیشود، اما نتیجه معمولاً بسیار نزدیک است.
- کیفیت Graph: عملکرد به ساخت درست Proximity Graph وابسته است. ساخت Graph محاسبات میخواهد، ولی معمولاً پیش از دریافت Prompt انجام میشود.
جمعبندی
- KNN سادهترین و دقیقترین روش Vector Retrieval است، اما هزینهٔ آن با تعداد اسناد خطی رشد میکند.
- ANN فضای جستوجو را محدود میکند و در برابر سرعت بیشتر، احتمال کوچکی از خطا را میپذیرد.
- NSW بردارها را به شکل Proximity Graph سازمان میدهد و از Node فعلی به همسایهٔ نزدیکتر حرکت میکند.
- HNSW چند لایهٔ Graph میسازد: لایههای بالا برای پرش سریع و لایهٔ پایین برای اصلاح دقیق.
- Vector Databaseهای مدرن معمولاً از الگوریتمهایی مانند HNSW برای Semantic Search در مقیاس Production استفاده میکنند.